
1. 推理的发展历程
2024 年之前,AI 领域主要专注于训练规模更大、性能更强的模型。2019 年 11 月发布的 GPT-2「只有」15 亿参数,而 2022 年 11 月推出的 GPT-3 则暴增至「庞大的」1,750 亿参数。然而,GPT-3 在处理复杂指令、可靠计算和长链条逻辑问题时往往表现不佳。
直到 2024 年 GPT-4o1 模型问世,人们才开始意识到,高性能模型可以通过在输出答案前进行多步逻辑分析来实现推理。
这也表明,增加参数量并非提升模型能力的唯一路径:在推理阶段分配更多计算资源,同样能够改善复杂任务的表现。
然而,推理需要更多的推理时计算,因此会带来更高的延迟和成本。如何在不牺牲推理性能的前提下降低延迟,遂成为一项重要的工程挑战。
随着智能体系统兴起,这一挑战变得更加突出——单个任务可能会反复调用模型与工具。OpenClaw 在 2026 年 1 月的迅速普及进一步凸显了这一趋势。因此,市场对推理优化的关注持续提升,vLLM、SGLang 等开源推理引擎也日益流行。
2. 推理产业栈与市场图谱
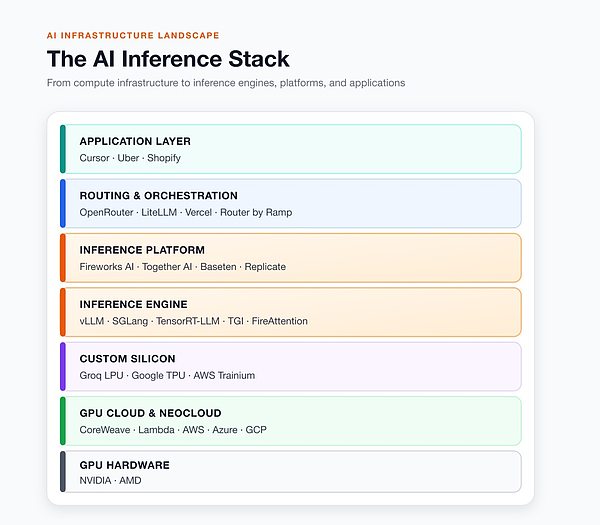
AI 推理栈的价值链可以分为七层,从面向用户的应用一直延伸到底层 GPU 硬件。
许多人会混淆路由层与推理平台之间的界限,因为两者看起来都为开发者提供可调用的 API 端点。但它们底层的商业模式截然不同。OpenRouter 本身并不拥有算力,而是在底层服务之上收取约 5% 的代币路由服务费。它通常聚合 Fireworks、Together AI 和 Baseten 等多家推理平台。
这是一个典型的平台型商业模式,其路径与 OpenSea 类似:一方面充当新发布、通常来源未公开模型(例如 Ox-Alpha,即 GLM 5.3 Flash)的发现层,另一方面作为推理服务商的分发平台。如果供需双方都在 OpenRouter 上形成规模,理论上它应当能够为特定模型提供最高效的价格发现。
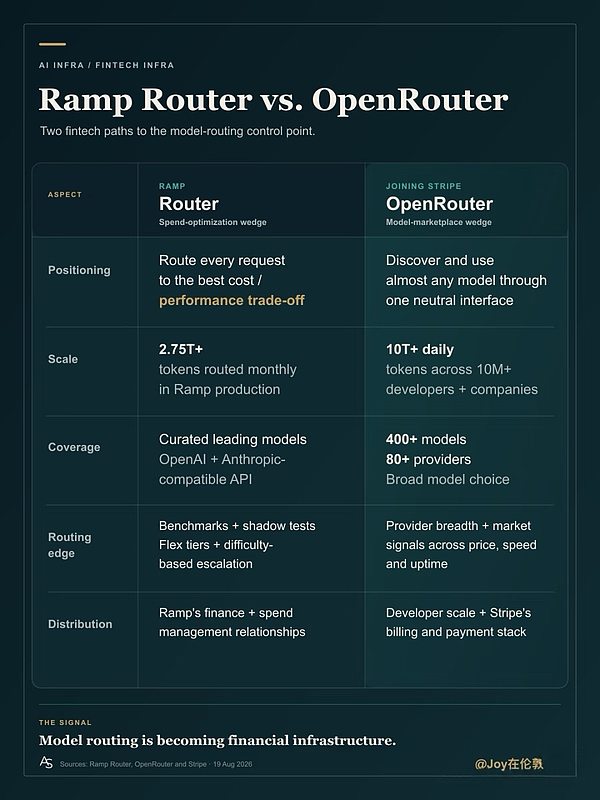
Stripe 以超过 70 亿美元收购 OpenRouter 的原因很直接:Stripe 已经掌握了 AI 应用的收入端,如今希望进一步掌握其成本端。Ramp 也意识到了这一点,并建立了自己的 Router.com 业务。
资本流与智能流开始趋于融合。它们押注未来几年 AI 原生和 AI 驱动型企业将快速增长,因此,同时掌控收入端与成本端的控制层,对维持其支付网关的主导地位至关重要。
推理市场本身是一个宽泛的类别。根据以下四项属性,可以将市场划分为四个象限:
算力所有权:外部拥有的算力 vs. BOYC(自带算力)
面向企业还是开发者的 GTM 策略
硬件要求
开源 vs. 闭源
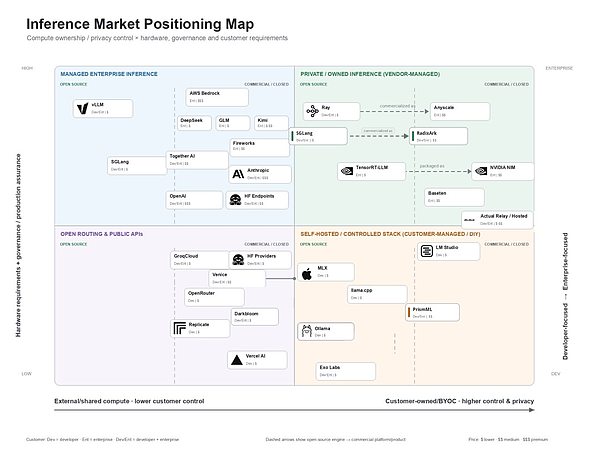
▲ 推理市场图谱涵盖云端推理、本地软件、客户自有算力编排,以及去中心化消费级硬件。SGLang 同时出现在托管推理和私有化部署两个象限;在右上象限中,它与其商业平台 RadixArk 相连接。PrismML 位于自托管边缘推理板块。
大多数推理公司起步于开源项目,随后为了实现商业化而逐渐发展为专有公司。
Fireworks 与 RadixArk 的创始团队展现了 AI 基础设施领域反复出现的一种商业化路径。Fireworks CEO Lin Qiao 曾在 Meta 领导 PyTorch 项目,联合创始人 Dmytro Dzhulgakov 则是 PyTorch 的最初创建者之一。Fireworks 并未直接将 PyTorch 商业化,而是把团队在分布式系统、GPU 内核和开发者基础设施方面的经验,转化为围绕开放权重模型构建的专有推理栈,其中包括 FireAttention、FireOptimizer 和托管式多云部署。
RadixArk 则体现了更直接的「开源到商业」转型。它由 SGLang 的创建者和核心维护者创立。SGLang 继续作为开源服务引擎和社区分发层,而 RadixArk 则通过托管基础设施、可靠性工具、企业支持,以及面向强化学习后训练的 Miles 框架,在其生产层实现商业化。
在这两个案例中,开源既是技术标准,也是获客渠道;商业公司则通过性能优化、运营可靠性、SLA 和企业集成来捕获价值。这种模式可以带来强大的分发能力,但底层引擎仍面临商品化风险。因此,真正可持续的护城河必须来自构建在开源项目之上的托管工作流与生产系统,而非开源项目本身。
垂直 AI 应用也开始向产业栈下游延伸。Harvey 最初依赖前沿模型 API,但如今已开始针对法律工作对 Harvey Tenet 等开放权重模型进行后训练,并建设基础设施,让各家律所能够拥有自己的专用模型。Genspark 仍在编排 70 多个外部模型,但也开始利用专有使用数据训练特定任务模型:Gen-1 Slides 利用大规模演示文稿生成中的反馈完成训练,其 Deep Research Agent 则通过 Fireworks 上的强化微调得到优化。
这并不意味着每一家应用公司都会成为基础模型实验室。相反,拥有专有数据且推理规模足够大的应用公司,可以选择性地将高频工作负载内部化。训练或后训练专用模型,能够带来更好的垂直领域表现、更低的边际推理成本,并减少对上游模型提供商的依赖;与此同时,前沿模型仍可继续处理复杂任务或长尾需求。
3. 推理代币经济学
仅看 Token 单价无法准确反映推理经济性。更好的指标是:在达到所需质量水平的前提下,综合考虑模型能力、GPU 利用率、延迟与可靠性之后的单个已完成任务成本。
闭源模型与开放权重模型的经济性
闭源模型通过订阅、用量额度和按量计费 API 实现商业化。订阅通常提供有限额度,而非固定数量的 Token;因此,额度耗尽后,API 价目表仍是真正的边际价格。
开放权重模型提供了另外两种选择:多家 API 托管商之间的竞争,以及在租用或自有 GPU 上进行自托管。在能力区间重叠时,服务商竞争与硬件可迁移性可以使开放权重模型的推理成本显著降低。闭源模型仍主导绝对能力前沿,并且对低用量、突发型或对 SLA 敏感的工作负载仍具吸引力。
利用率比最新 GPU 更重要
只有当硬件利用率足够高时,自托管才具备经济性。每 Token 成本大致可表示为:

最新的 GPU 并不一定是成本最低的选择。稠密、延迟敏感型模型可能受益于 H100 或 Blackwell;而稀疏或 MoE 工作负载在较旧的 A100 上运行,反而可能更经济。Ornn 的分析显示,工作负载形态与有效利用率可能会逆转人们对硬件排名的直觉,从而延长旧款 GPU 的经济寿命。
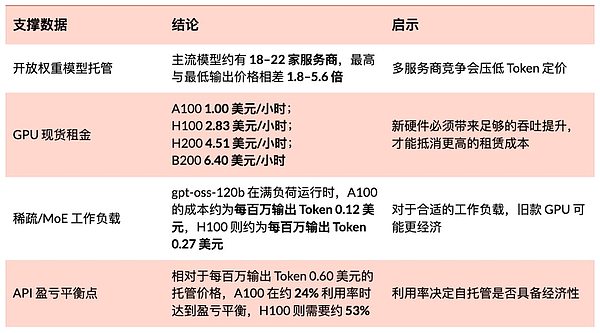
以上数据基于 Ornn Data 2026 年 9 月的快照与建模假设,仅具有方向性,并非通用基准。
核心结论
衡量单位智能成本,而非单位 Token 成本。
当能力足以满足需求时,开放权重模型会压低价格。
闭源 API 在能力前沿,以及便利性或可靠性方面仍保有定价权。
路由之所以有价值,是因为不同任务对应的最低成本模型与硬件并不相同。
推理价格将持续下降,但智能体工作负载带来的 Token 总需求增长,可能快于单位成本的下降速度。
4. 最新推理趋势
AI 推理正走向混合架构。前沿推理和大规模工作负载仍将留在数据中心,而规模较小、重复性高、隐私敏感且对延迟要求高的任务,将越来越多地在 PC、工作站、手机和边缘设备上运行。
以下三大趋势正在推动这一转变:
推理需求增加:推理模型每次回答消耗更多计算,而智能体会反复调用模型与工具。
开放权重模型进步:能力较强的模型如今可以下载并自托管,不再只能通过云端 API 访问。
效率提升:量化、蒸馏、推测解码和低比特模型降低了内存与算力需求。例如,PrismML 表示其 1-bit Bonsai 8B 模型仅占用约 1GB 内存,而 FP16 版本约需 16GB。
JEPA 及类似架构通过预测抽象表征,而非重建每一个像素,可能进一步减少不必要的计算。然而,它们仍然需要推理。正确的结论是推理成本降低,而非不再需要推理。
本地与边缘推理
本地推理正在从爱好者场景走向更广泛的实用应用。最适合的用例是高频且对隐私敏感的工作负载,例如个人智能体、会议转录、文档搜索、编程辅助、计算机视觉和机器人。
其优势十分明确:
更低延迟,并支持离线使用
对私有数据拥有更强控制力
购买硬件后不再产生边际 API 成本
对稳定工作负载而言,经济性更可预测
主要限制在于:在一台设备上运行模型很容易,但管理大量设备却很困难。企业仍然需要跨不同 Mac、PC 和 GPU 实现路由、身份验证、模型更新、日志、监控和故障切换。
这正是Actual Computer所瞄准的机会:客户拥有硬件,而 Actual 提供运行时、API、中继与设备集群管理层。最终形态很可能不是本地取代云端,而是混合路由——简单且私密的任务在本地运行,复杂任务则发送至云端前沿模型。
AI PC 与硬件换机周期
AI 推理可能带来一轮可观的 PC 换机周期。Gartner 预计,AI PC 出货量将从 2025 年的 7,780 万台增至 2026 年的 1.431 亿台。
然而,仅凭 NPU TOPS 并不能判断一台 PC 是否可以运行实用的本地 AI。完整系统才是关键:
NPU:低功耗、常驻型功能与小模型
GPU:更大的生成式模型与更高吞吐量的工作负载
CPU:编排与通用兼容性
内存:往往是制约模型规模和上下文长度的关键因素
Apple 的优势在于统一内存,NVIDIA 的优势来自 CUDA 及其推理软件生态,Windows AI PC 则拥有广泛的 OEM 分销网络。在中国,联想可以向庞大的企业客户群分销支持 AI 的 ThinkPad 和工作站;华为则围绕昇腾硬件、CANN/MindIE,以及与 PyTorch、Triton 和 vLLM 的集成,构建国产技术栈。